2026年11月のSEO最新ニュースレポートです。今月は、Googleが偽の作成者プロフィールやAIで作った記事についてガイドラインを更新したことに加え、AI OverviewsやChatGPTがどのサイトを引用しているかを調べたデータが相次いで公開され、「AIに信頼できる情報源として選ばれるか」が検索対策の中心になりつつあることがはっきり見えた月でした。作成者情報の正確な開示、一次情報の発信、公式サイトの事実情報の整備、アクセス解析での「ダイレクト」流入の見直しといったテーマは、どれもサイト運営の現場で今日から着手できるものです。本記事では、SEOに関する海外・国内の最新動向から12のトピックを取り上げ、それぞれの要点と実務に活かすための対応策を解説します。
- 1 今月の12トピック一覧
- 2 1. Google、ヘルプフルコンテンツガイドラインに偽著者警告を追加
- 3 2. AI Overviewsが現在、ブランド検索の83%に表示
- 4 3. AI記事は人間が確認、架空の専門家はNG。Googleがコンテンツの信頼性について注意喚起
- 5 4. AI検索の引用ドメインランキング、YouTubeが1位→5位に後退! 新たな首位は?
- 6 5. ChatGPTが引用するサイトは一次情報・データ中心へ
- 7 6. ChatGPTはどのようにクエリのファンアウトを行うか(1500万クエリを調査)
- 8 7. Bing Webmaster Tools、AI検索クエリをトピック別に分類
- 9 8. AI検索からのクリックが増えるか? GoogleがAI ModeとAI Overviewsのリンク表示を強化
- 10 9. インテリジェントな新しいショッピングカート
- 11 10. Gemini 経由の訪問が「ダイレクト」に? UTM タグで見えた隠れた流入
- 12 11. Meta MuseやOpenAI DotsのようなパーソナルAIエージェントがSEOに与える意味
- 13 12. Google DiscoverのSDF鮮度アルゴリズムに関する詳細が明らかに
- 14 よくある質問
- 15 まとめ|2026年11月のSEOで押さえること
今月の12トピック一覧
今回取り上げるのは、注目の12トピック。それぞれの内容を簡潔にまとめていますので、気になるものからぜひご覧ください。
| # | トピック | 一言でいうと |
|---|---|---|
| 1 | 偽の著者プロフィールに警告 | AI生成の顔写真や架空の経歴は「欺瞞」。 低品質ページのシグナルに |
| 2 | ブランド検索とAI Overviews | 9月29日時点で82.91%に表示。 月平均は7月から12ポイント増 |
| 3 | AI記事は人間が確認 | 公開前のファクトチェックは必須。 人の「労力」が評価される |
| 4 | AI検索の引用ドメイン(日本) | Wikipedia日本語版が1位に。 YouTubeは5位に後退 |
| 5 | ChatGPTの引用元の変化 | PubMedが64位→4位。 WebMDは18位→79位 |
| 6 | ChatGPTのファンアウト調査 | Web検索は応答の14.4%。 事実確認では84.4%が公式ソース |
| 7 | Bing「Topics Portfolio」 | 引用されていない「機会クエリ」が分かる。 ベータ版 |
| 8 | AI検索のリンク表示強化 | インラインリンクを上部に。 末尾のリンクにサムネイル |
| 9 | Google「Universal Cart」 | 複数の小売店の商品を1つのカートで管理。 米国で提供 |
| 10 | Gemini経由の隠れた流入 | 実際のクリックはリファラー計測の2.1倍 |
| 11 | パーソナルAIエージェント | Museはアクセシビリティツリーでページを読む。 robots.txtでは指定できない |
| 12 | Discoverの鮮度フィルター | 2つのフィルターで古い記事を除外。 古い内容への苦情は54.9%減 |
1. Google、ヘルプフルコンテンツガイドラインに偽著者警告を追加
Googleはサイトオーナー向けのヘルプフルコンテンツガイドラインを更新し、偽の作成者プロフィールを「欺瞞」とはっきり位置づけました(10月1日付)。AIで生成した顔写真や架空の経歴を使って人間の専門家を装う行為は、低品質ページのシグナルになると警告しています。
何が書き加えられたか
欺瞞とされたのは、AIで生成した顔写真(プロフィール写真)、架空の名前、偽りの資格・経歴です。Googleが問題にしているのは、人間の専門家がいるように見せかけようとする意図そのものです。こうした欺瞞は、ユーザーからの信頼も、Googleの自動品質システムからの評価も下げます。品質評価ガイドラインでは欺瞞行為は「低品質ページ」のシグナルで、「最低評価」の対象です。自動品質システムも同じように信頼性が低いと判断します。
著者情報の位置づけ
GoogleのSearch Liaisonは2024年1月に、記事の著者名(バイライン)を載せても順位は上がらないと発言しています。今回の更新は「著者情報を載せれば評価が上がる」という話ではなく、偽のプロフィールを欺瞞として明確に指摘し、本物の専門性があるように誤解させる行為を監視するというものです。なお、品質評価ガイドラインの欺瞞の項目はより範囲が広く、偽のビジネス情報、なりすまし、欺瞞的なページデザインも含みます。今回のサイトオーナー向けガイドラインは、そのうち偽の作成者プロフィールに絞った内容です。
実務での対応
記事の書き手として載せる人物は、実在の担当者と実際の経歴にそろえてください。架空の専門家を立てると、SEO上のリスクが大きくなります。誰が書いたのかを正確に示すことが、サイトの透明性と信頼性を保つための前提です。
2. AI Overviewsが現在、ブランド検索の83%に表示
Ahrefsが2026年7月から9月の米国のデスクトップ検索結果(約2億3,280万件)を分析したところ、9月29日時点で、ブランド名を含む検索の8割以上にAI Overviews(AIO)が表示されていました。WikipediaやYouTubeなど第三者のサイトが情報を発信する場面が広がり、ブランドのクリック率の低下や、自社の情報を管理しにくくなることが課題になっています。
数字で見るAIOの広がり
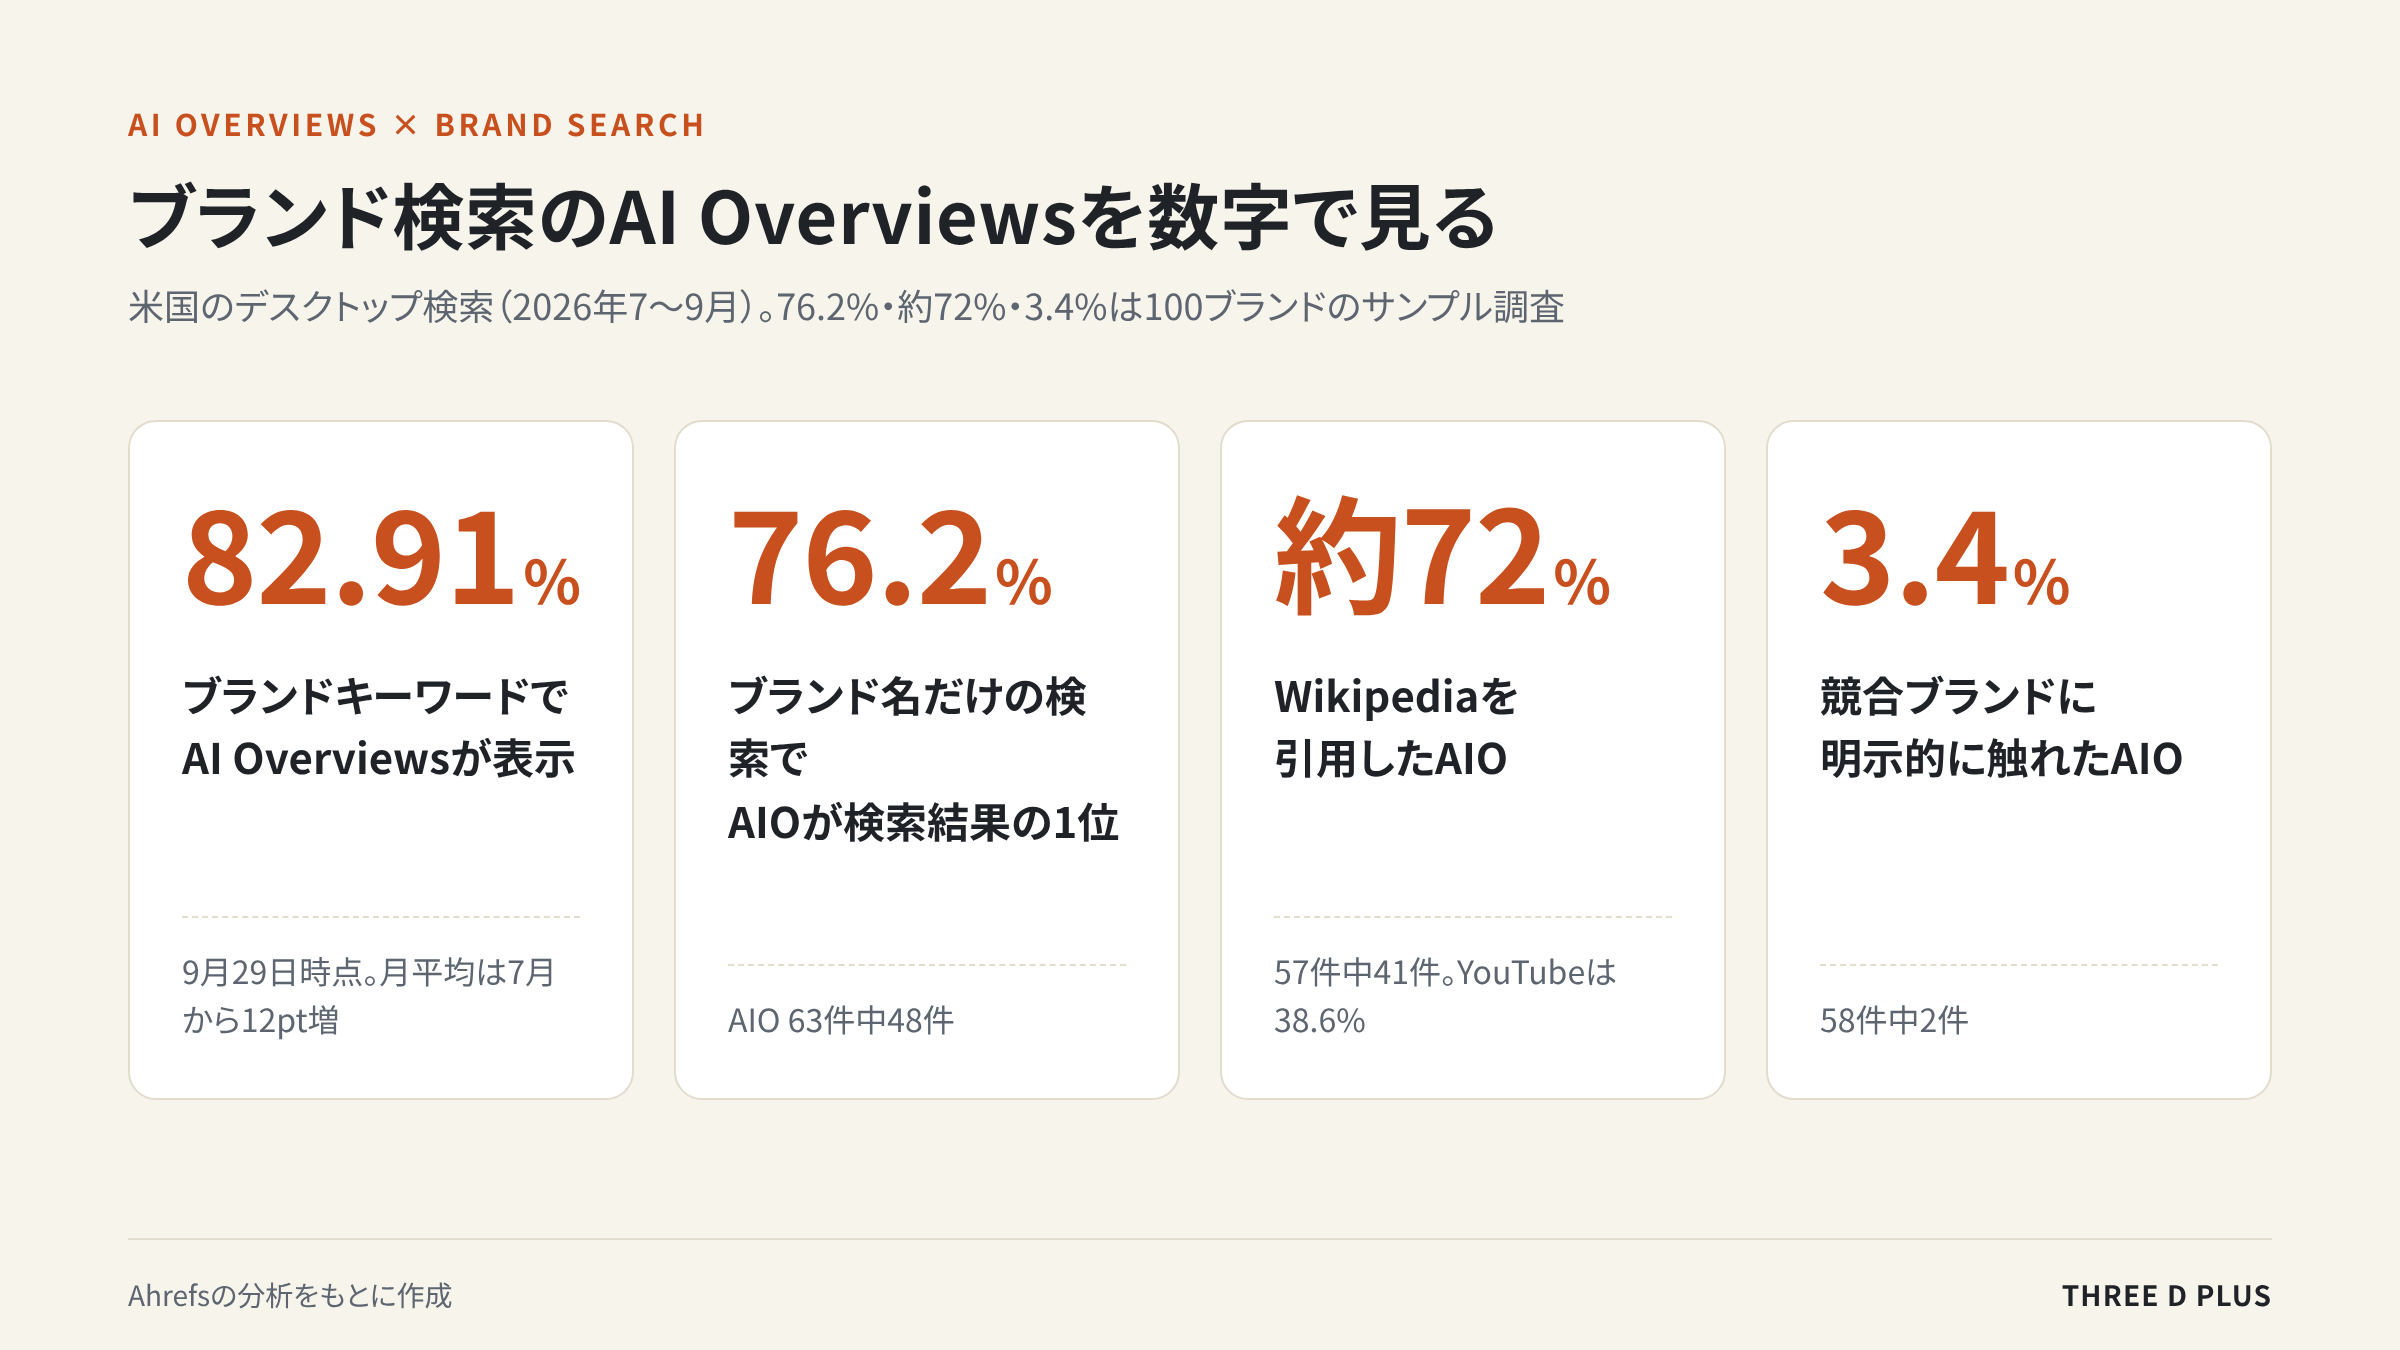
2026年9月29日時点で、ブランドキーワードの検索結果の82.91%にAIOが表示されていました。月平均で見ると、7月の61.3%から9月は73.3%へ12ポイント増え、約20%の伸びです。非ブランドキーワードとの差も、7月の12.2ポイントから9月は5ポイントに縮まりました(非ブランドは73.5%から78.3%)。また、100ブランドについてブランド名だけで検索した調査では、表示されたAIO 63件のうち48件(76.2%)が検索結果の1位にあり、ブランドの公式サイトより上に来る傾向が見られました。
AIOは何を情報源にしているか
同じ調査で情報源を見ると、AIO 57件のうち41件(約72%)がWikipediaを引用しており、YouTubeは38.6%、LinkedInは22.8%でした。ブランドが内容を管理しにくい外部サイトがよく使われています。一方で、全文を確認できたAIO 58件のうち、競合ブランドに明示的に触れたのは2件(3.4%)だけで、競合企業のサイトが情報源に入ったのも57件中1件でした。なお、これらの数字は100ブランドの小さなサンプルによるものです。
実務での対応
ブランド名で検索されてもクリックされにくくなり、公式情報にたどり着く人が減ると考えておく必要があります。自社名で検索したときにAIOが表示されるか、どの情報源が参照されているかを定期的に確認してください。自社の情報が第三者のサイトに左右されるリスクにも備えておきましょう。
参照:Ahrefs
3. AI記事は人間が確認、架空の専門家はNG。Googleがコンテンツの信頼性について注意喚起
Googleが、生成AIを使ったコンテンツとコンテンツ品質に関するガイドラインを更新しました。AIが事実と異なる内容を作ってしまう(ハルシネーション)ことを前提に、公開前に人の手でファクトチェックとレビューを行うよう強調しています。あわせて、メインコンテンツの品質を評価する基準を明確にし、作成にかけた人間の「労力」を重視する姿勢を示しました。
AIで作る記事の決まり
生成AIは次に来る単語を予測して文章を作るため、ハルシネーションが起こる可能性があります。そのため、公開前の手動のファクトチェックとレビューは必須です。本文だけでなく、メタデータも正確さと信頼性を確認する対象になります。
「労力」で評価されるメインコンテンツ
E-E-A-Tに加えて、メインコンテンツの品質が重要とされました。メインコンテンツはページの目的を果たすことに直接関わる部分で、検索品質評価者は労力・独自性・スキル・正確性を見て評価します。人が手を動かした作業や独自の分析は「労力が高い」、AIで大量のテキストを自動生成したものは「労力が低い」とされます。参照元を明記しても、独自の労力の代わりにはなりません。また、AIで生成した顔写真、架空の名前、偽の経歴といった偽りの作成者情報は欺瞞行為で、ユーザーと自動品質システムの両方からの信頼を損ない、低品質なページであることを示すシグナルになります。
実務での対応
AIで作った記事も、公開前に必ず人が厳しくチェックしてください。独自の調査や分析など、手間と独自性をかけた内容にすることが評価の前提です。作成者の情報は正直に載せましょう。AIを使う場合でも、人が関わって品質と信頼性を担保すること、特にファクトチェックと透明性の確保は、サイト運営に欠かせない条件になっていきます。
4. AI検索の引用ドメインランキング、YouTubeが1位→5位に後退! 新たな首位は?
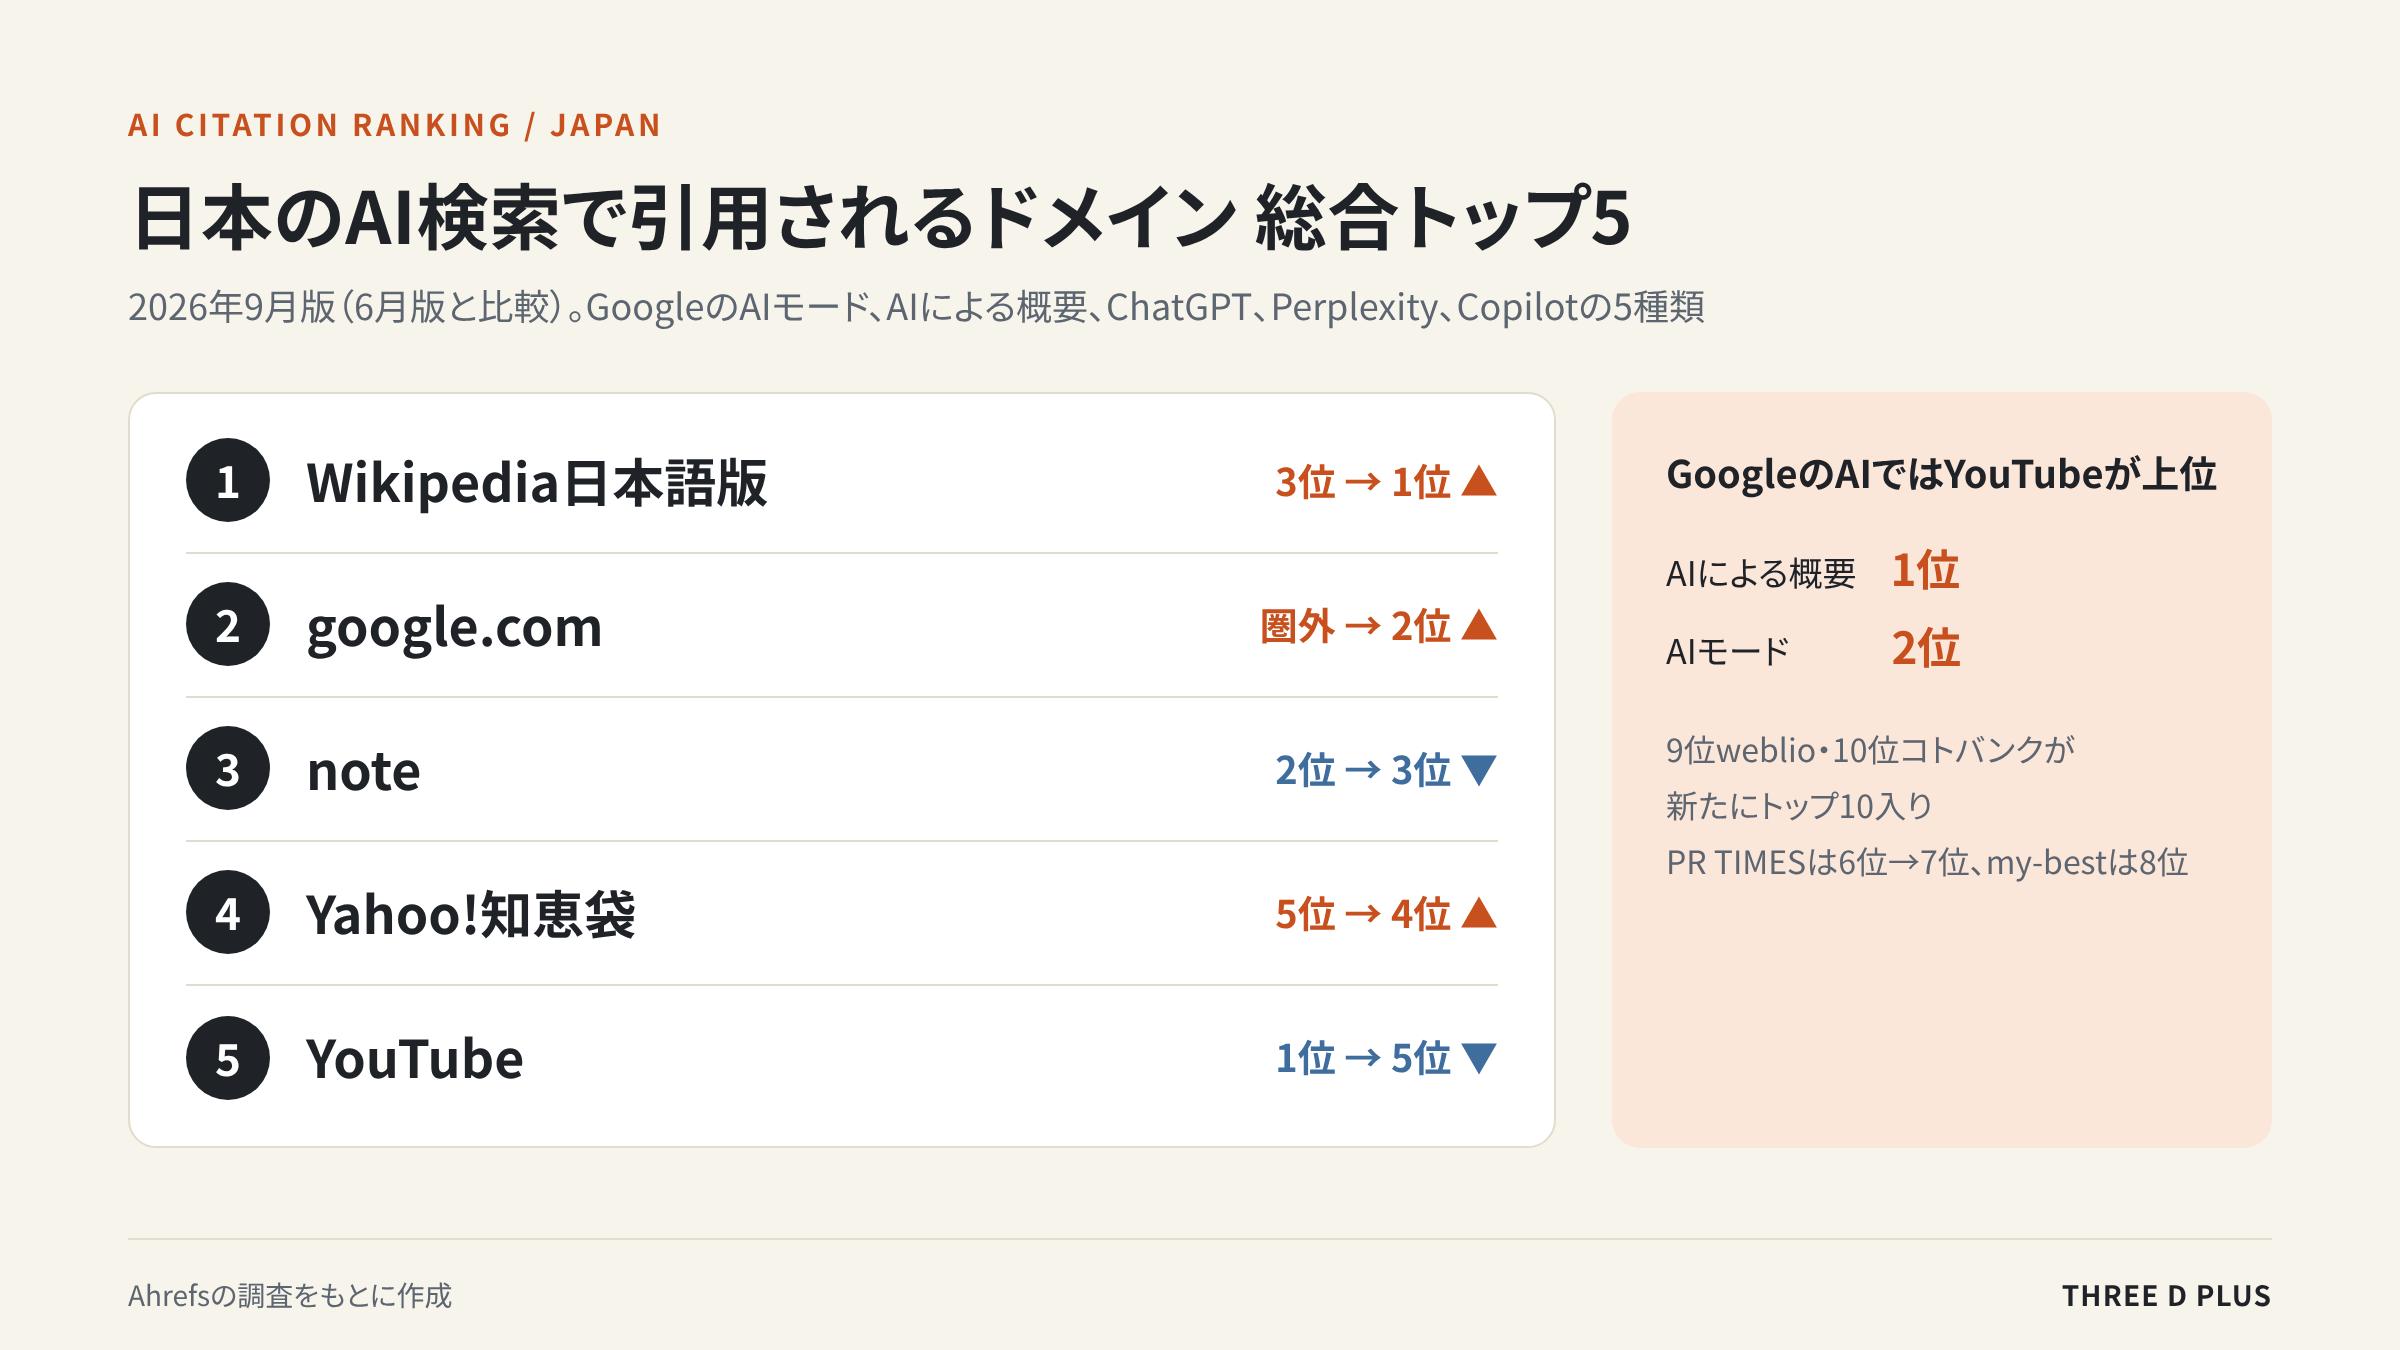
Ahrefsが、日本のAI検索でよく引用されるドメインのランキング(2026年9月版、調査は9月29〜30日)を発表しました。GoogleのAIモード、AIによる概要、ChatGPT、Perplexity、Copilotの5種類の回答で引用されたドメインを分析し、6月版と比べたものです。総合ではWikipedia日本語版が首位に上がり、前回首位のYouTubeは5位に下がりました。
Photo by Myriam Jessier on Unsplash
総合ランキングの変化
Wikipedia日本語版は3位から1位へ上がり、YouTubeは1位から5位へ後退しました。google.comは圏外から2位に急浮上し、noteは2位から3位、Yahoo!知恵袋は5位から4位です。9位にweblio、10位にコトバンクが新たに入り、Wikipediaと合わせて辞書・百科事典系がトップ10のうち3つを占めました。PR TIMESは6位から7位に下がり、my-bestは前回と同じ8位です。6月版でChatGPTの引用元1位だったRedditは、今回は5つのAIすべてでトップ10から外れました。
AIサービスごとの違い
YouTubeは総合では5位でも、GoogleのAIでは上位にいます。AIによる概要では1位、AIモードでは2位です。AIサービスによって、どのサイトを引用するかの偏りがはっきり分かれています。なお、2026年7〜8月に分析対象の質問数が約1,400万件から約3,000万件に増えたため、6月版との比較は引用回数ではなく順位の変動を中心にしています。
実務での対応
AI検索で参照されるドメインは大きく入れ替わるため、変化を継続して見ていく必要があります。GoogleのAIではYouTubeが引き続き重要ですが、全体ではWikipediaや辞書系など権威性のある情報源の存在感が増しており、その重要性はSEOでもMEOでも高まっています。どのAIサービスで見つけてもらいたいかによって、コンテンツの作り方を変えることも検討してください。
参照:Web担当者Forum
5. ChatGPTが引用するサイトは一次情報・データ中心へ
Ahrefsのデータによると、ChatGPTが引用するサイトは、元の情報を出している一次情報や専門機関のサイトへ移りつつあります。3月から9月にかけて、PubMedなど専門機関の順位が上がり、WebMDのような要約・解説サイトの順位は大きく下がりました。無料で使ったときの応答で、Web検索がどのくらい使われているかも分析されています。
引用元はどう変わったか
ChatGPTは、要約サイトよりも元の情報を出している一次情報源を重視するようになっています。政府系サイトや規制機関が順位を上げ、Investopediaなどの要約・解説サイトは順位を落としました。主な変化は次のとおりです。
| 対象 | 3月 | 9月 |
|---|---|---|
| PubMed(医学論文のデータベース)の順位 | 64位 | 4位 |
| WebMD(健康情報の解説サイト)の順位 | 18位 | 79位 |
| Redditを引用した回答の割合(米国) | 19.1% | 2.3% |
| Wikipediaを引用した回答の割合 | 14.1% | 2.9% |
RedditとWikipediaは大きく減ったものの、今もよく引用されるドメインに入っています。
Web検索の使われ方と、データの見方
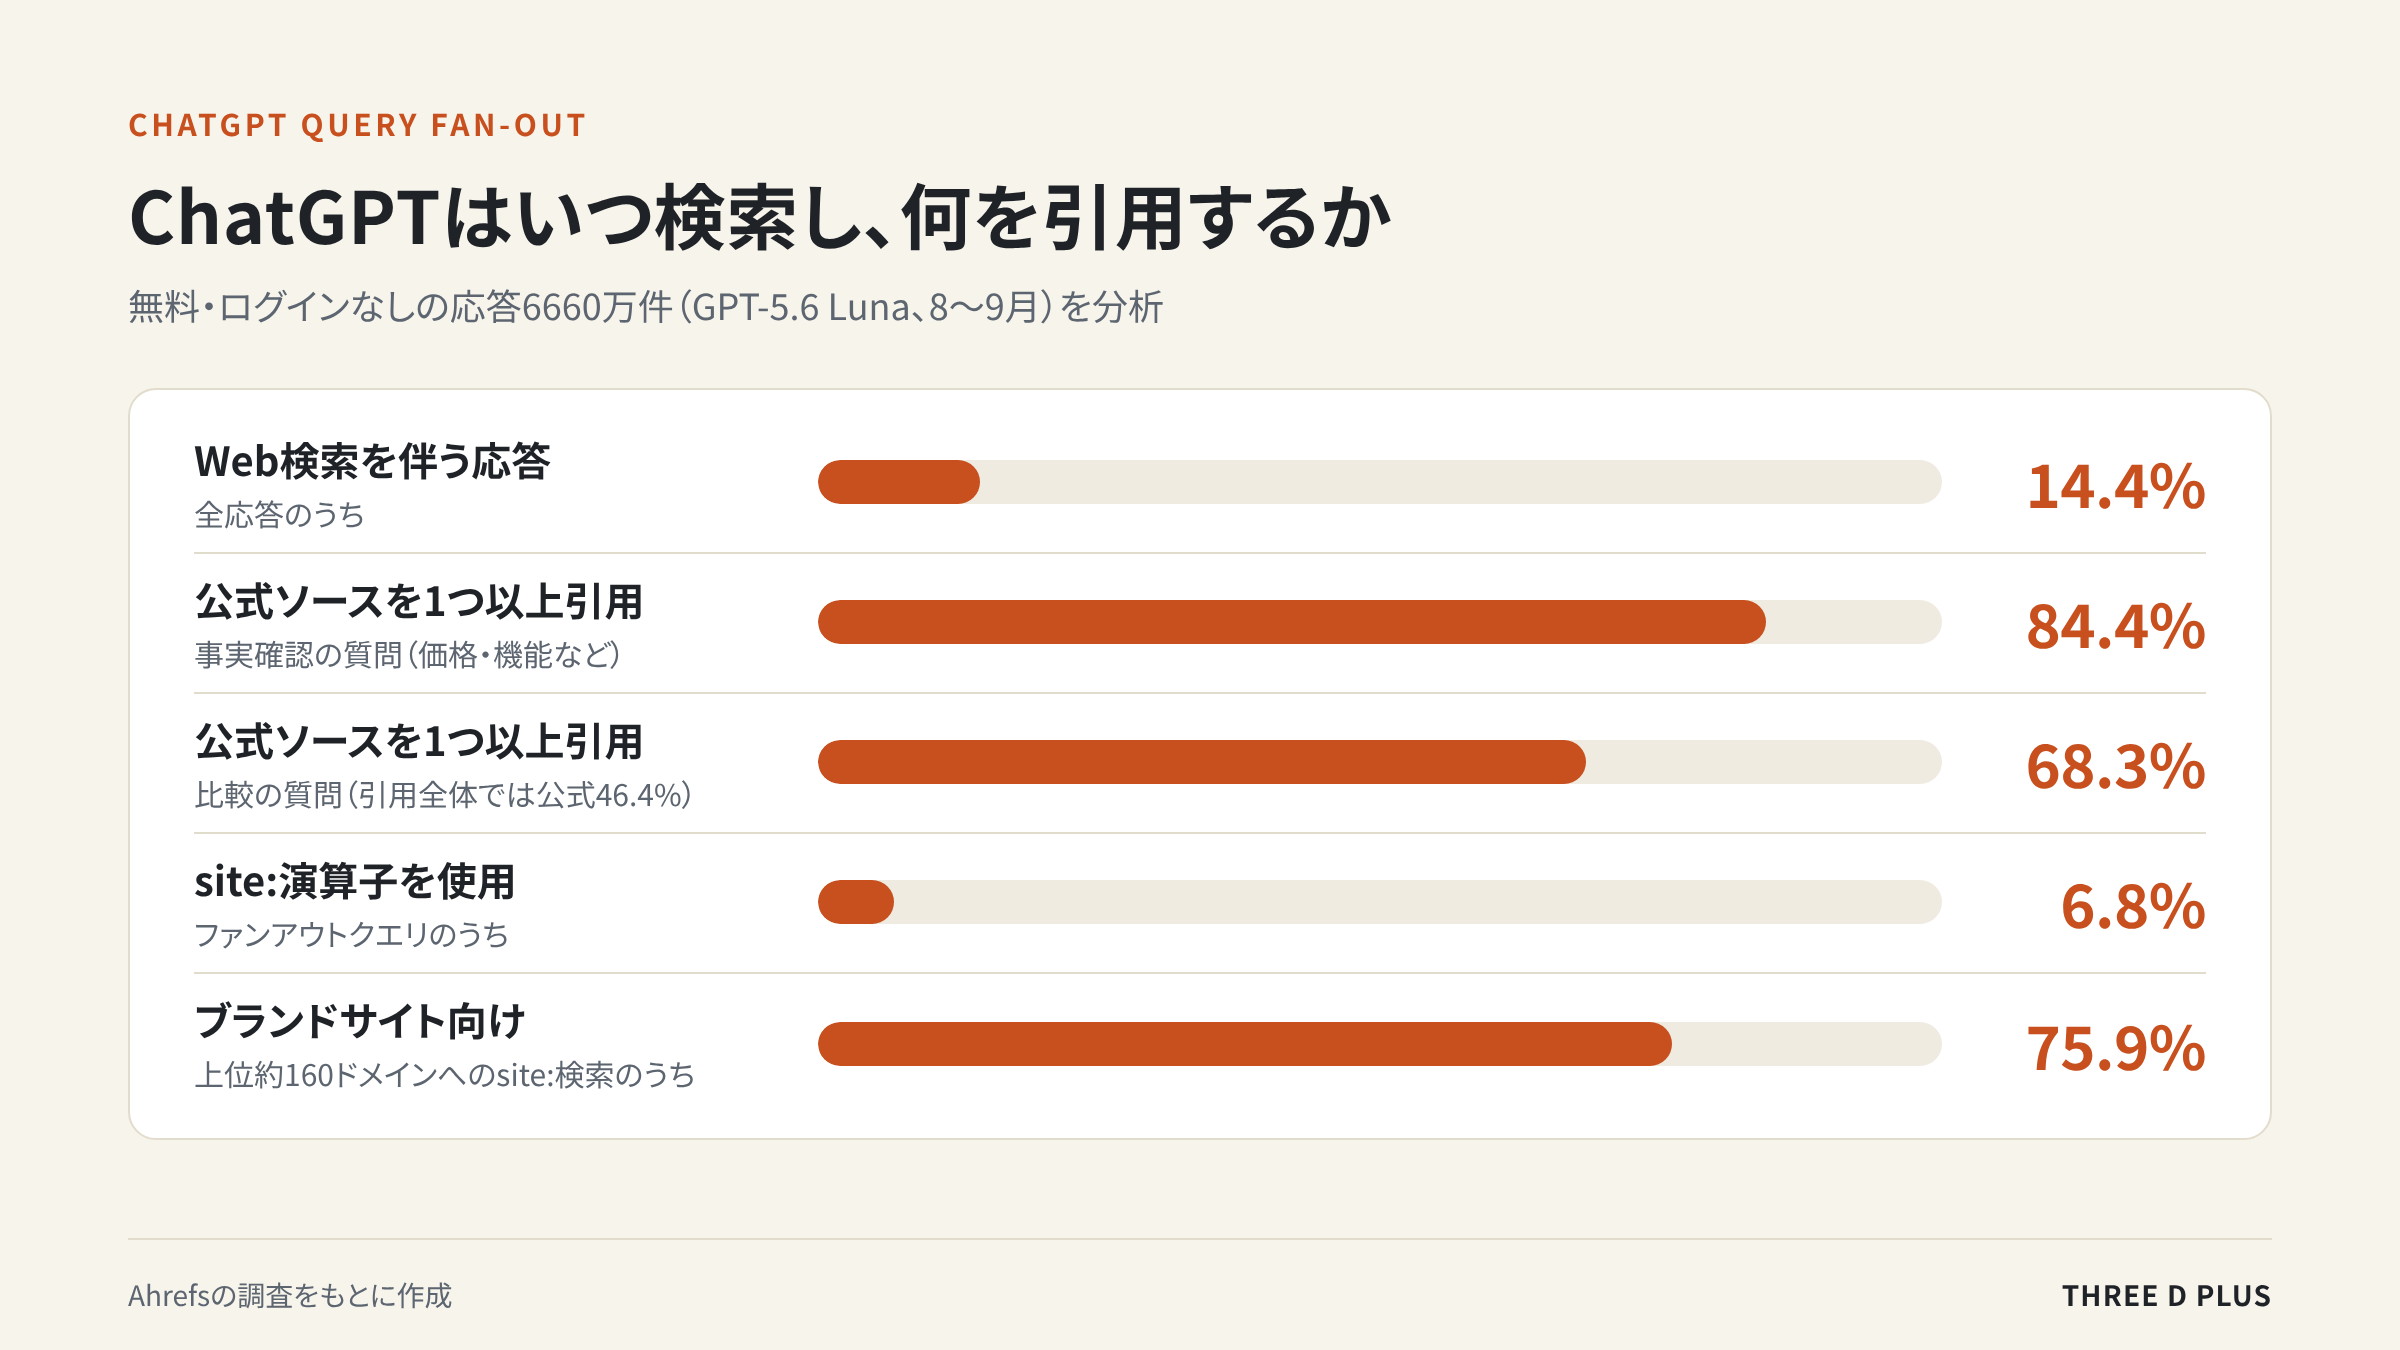
8〜9月の無料・ログインなしの応答6660万件のうち、Web検索を伴うのは14.4%でした。検索を伴う応答では、平均約1.6回のファンアウトクエリ(回答を作るためにAIが行う検索)が発生します。よく検索される約160のドメインに対するsite:検索では、75.9%がブランドのサイトに向けられていました。ただし、このデータは1つのモデル(GPT-5.6 Luna)と期間を切り取ったものです。他社の調査と数字が違うのは、モデル、プロンプト、収集方法の違いによります。無料・ログインなしの利用では、Web検索をする頻度が低い傾向もあります。
実務での対応
オリジナルの調査や実地テストなど、自社にしかない情報を持つコンテンツを重視してください。自社のコンテンツがChatGPTにどう引用されているか、競合はどうかを定期的に確認し、モデルが更新されたときには引用元の変化に合わせて見直しましょう。ChatGPTが専門性の高い一次情報を選ぶようになったことは、独自の知見や検証データの価値が上がっていることを示しています。
6. ChatGPTはどのようにクエリのファンアウトを行うか(1500万クエリを調査)
Ahrefsが、無料版ChatGPTの6660万件の応答と約1500万件のファンアウトクエリを分析しました。ChatGPTがどのくらいWeb検索をし、どの情報源を優先するかを調べたものです。多くの応答はWeb検索をせずに答えており、検索するときはブランドサイトや公式の情報源を重視する傾向が分かりました。
いつ検索し、何を引用するか
対象は無料・ログインなしのChatGPT(GPT-5.6 Luna)の応答で、期間は8〜9月です。Web検索をしたのは全体の14.4%だけでした。価格、製品の機能、企業情報など事実を確かめる質問では、84.4%が少なくとも1つの公式ソースを引用しています。「A vs B」のような比較の質問でも68.3%は公式ソースを1つ以上引用していますが、引用全体に占める公式サイトの割合は46.4%で、半分以上は他のサイトからの引用です。事実は公式、比較は多様な情報源という使い分けです。
ファンアウトクエリの中身
ファンアウトクエリの6.8%はsite:演算子を使って特定のサイトを検索しており、よく検索される約160のドメインで見ると75.9%がブランドサイト向けです。「公式」「価格」という語がよく使われ、製品の価格や仕様の確認に使われています。site:検索の対象としてはブラジル政府のgov.brが10番目に多く、YMYLの質問ではChatGPTが公式の情報源を好むという指摘(Lily Ray氏)も紹介されています。Redditは今もsite:検索の対象として9番目に多いドメインですが、引用は3月から9月にかけて88%減りました。クエリの傾向としては「価格」「仕様」「レビュー」関連が増え、「価格」は47%増、「レビュー」は約3分の1増え、「仕様」はトップ50に入りました。逆に「意味」「定義」はそれぞれ約2割減っています。
引用元の変化
OpenAIと提携しているメディア(提携パブリッシャー)の引用シェアは、3月の7.5%から7月には15.8%と2倍以上になり、9月下旬も12.5%ありました。3月から9月にかけての引用は、Redditが88%減、Wikipediaが80%減、YouTubeが27%減と大きく減り、その分が研究機関、規制機関、ブランド、実機テストを行うレビューサイトに移っています。情報をまとめたサイトより、一次情報源が優先される流れです。
実務での対応
自社サイトには、価格、仕様、サポート情報などの事実を正確に載せてください。オリジナルの調査、実機テスト、製品情報は自社サイトで公開しましょう。ChatGPTの提携パブリッシャー経由で露出することも検討の余地があります。ChatGPTが求める情報(レビュー、比較など)は業界や商品によって違うため、自社の市場に合わせて分析し、モデルの更新による変化も定期的に追ってください。信頼性の高いオリジナルコンテンツを出すことが、自社ブランドのSEOでますます重要になります。
参照:Ahrefs
7. Bing Webmaster Tools、AI検索クエリをトピック別に分類
Bing Webmaster Toolsに「Topics Portfolio」のベータ版が加わりました。AIの回答で引用されたクエリをトピックごとに分け、他のサイトは引用されているのに自サイトは引用されていない「機会クエリ」を示す機能です。コンテンツの抜け(カバレッジギャップ)を見つけたり、AI検索での存在感を高めたりするのに使えます。
Photo by Zulfugar Karimov on Unsplash
何が見られるか
「AI Performance」レポートの新しいタブにあり、AI回答に引用されたクエリを大まかなトピックに分類します。各トピックには次の3つの指標が付きます。
| 指標 | 内容 |
|---|---|
| Topic Size | 選んだ期間に、そのトピックで全サイトが引用された回数の推定合計 |
| Sites Cited | そのトピックのクエリで引用されたサイトのおおよその数 |
| Queries | そのトピックに含まれる、回答の根拠になったクエリのおおよその数 |
表の下の「Top Opportunity Queries」では、自サイトが引用されていないクエリを一覧できます。トピックをクリックすると詳細ページが開き、期間は1〜3か月から選べます。サイトのデータが十分にない場合は表示されません。
これまでの機能との違いと、ベータ版の注意点
以前の「Topics」は、自サイトが引用されたクエリをまとめるだけでした。Topics Portfolioはトピック単位で全サイトの引用数を表示し、自サイトが引用されていないクエリもリストにできます。「Citation Share」は、競合のドメイン名を出さずに相対的な存在感を示します。ただし、トピックの分類はAIが行うため利用者の感覚とずれることがあり、機会クエリに競合ブランドの検索語が含まれる場合もあります。数値は「計画の方向性を示す信号」で、厳密なものではありません。結果に評価を付けるフィードバック機能(Thumbs up/down)があります。
実務での対応
コンテンツ担当者がカバレッジギャップを見つけるのに役立ちます。自社が扱うトピックで、AI検索のどこに競争の機会があるかを把握してください。数値は「方向性の目安」として計画づくりに使い、フィードバックを送ってツールの精度向上にも協力しましょう。精度が上がれば、機会クエリを起点にコンテンツを企画しやすくなります。
8. AI検索からのクリックが増えるか? GoogleがAI ModeとAI Overviewsのリンク表示を強化
GoogleがAI Mode(AIM)とAI Overviews(AIO)を更新し、AIの回答からウェブサイト、ニュース、クリエイターのコンテンツへ誘導する仕組みを強めました。インラインリンクの表示位置を上げたり、公式ページを目立たせたりして、ユーザーが関連情報にアクセスしやすくしています。
変更の内容
リンクの表示では、AI回答の中のインラインリンクが上の方に表示される頻度が上がり、回答の最後に並ぶリンクにはサムネイルが付いてクリックされやすくなりました。ニュースでは、トップニュースのカルーセルを展開する国・言語・クエリが広がり、ユーザーが登録した「優先ソース」が強調されます。優先ソース機能の利用者は、年初から7倍超に増えています。公式・専門のコンテンツについては、特定の公式ページ専用のセクションに表示する形がテストされています。クリエイター向けには、AIMの動画結果からクリエイターのプロフィールへリンクする機能がテスト中で、クリエイターの活動を広く知ってもらう狙いです。
実務での対応
AI検索からウェブサイトへの流入経路は増えており、その重要性も高まっています。公式情報や専門的なコンテンツの質を上げ、それを目立つ形で示すことが大切です。動画で発信している場合は、クリエイターとしてのブランディングや露出の機会も広がります。GoogleのAI検索はサイトへのアクセスをこれまで以上に重視する方向に進んでおり、質の高いコンテンツや公式情報の発信が、AI経由の露出を増やすことにつながるでしょう。
9. インテリジェントな新しいショッピングカート
Googleが新しいショッピングカート機能「Universal Cart」を米国で始めました。Google検索とGeminiアプリをまたいで、複数の小売店の商品をまとめて管理し、価格や在庫の追跡、割引の自動適用、スムーズな決済までをまとめて行える、買い物の新しい拠点です。
Universal Cartでできること
米国のGoogle検索とGeminiアプリで使える、Google横断の買い物ハブです。複数の小売店の商品を1か所に保存でき、買い物の途中経過も自動で保存されるので、後から再開しやすくなります。ブラウザのタブやスクリーンショットで商品を控えておく必要がなくなります。600億件を超える商品リスティングを持つShopping Graphを基盤に、値下がりや在庫の復活を知らせます。Google Walletと連携してカードの特典を使え、関連するプロモーションコードもカートに表示されます。決済はGoogle Payで安全に行え、販売店のカートに商品を移すこともできます。Nike、Sephora、Target、Ulta Beauty、Walmart、Wayfair、多くのShopify加盟店などが対応しています。
実務での対応
現時点では米国での提供ですが、Googleのサービスの中で購入まで完結する流れが強まっています。商品情報をGoogleに提供してShopping Graphで活用されるようにしておくこと、Google Payやプロモーションと連携する機会が広がることを押さえておきましょう。オンラインショッピングの手間を減らし、多くの商品を比較するときに特に役立つ機能なので、EC事業者にとっては商品情報の整備がより大切になります。
参照:Google公式ブログ
10. Gemini 経由の訪問が「ダイレクト」に? UTM タグで見えた隠れた流入
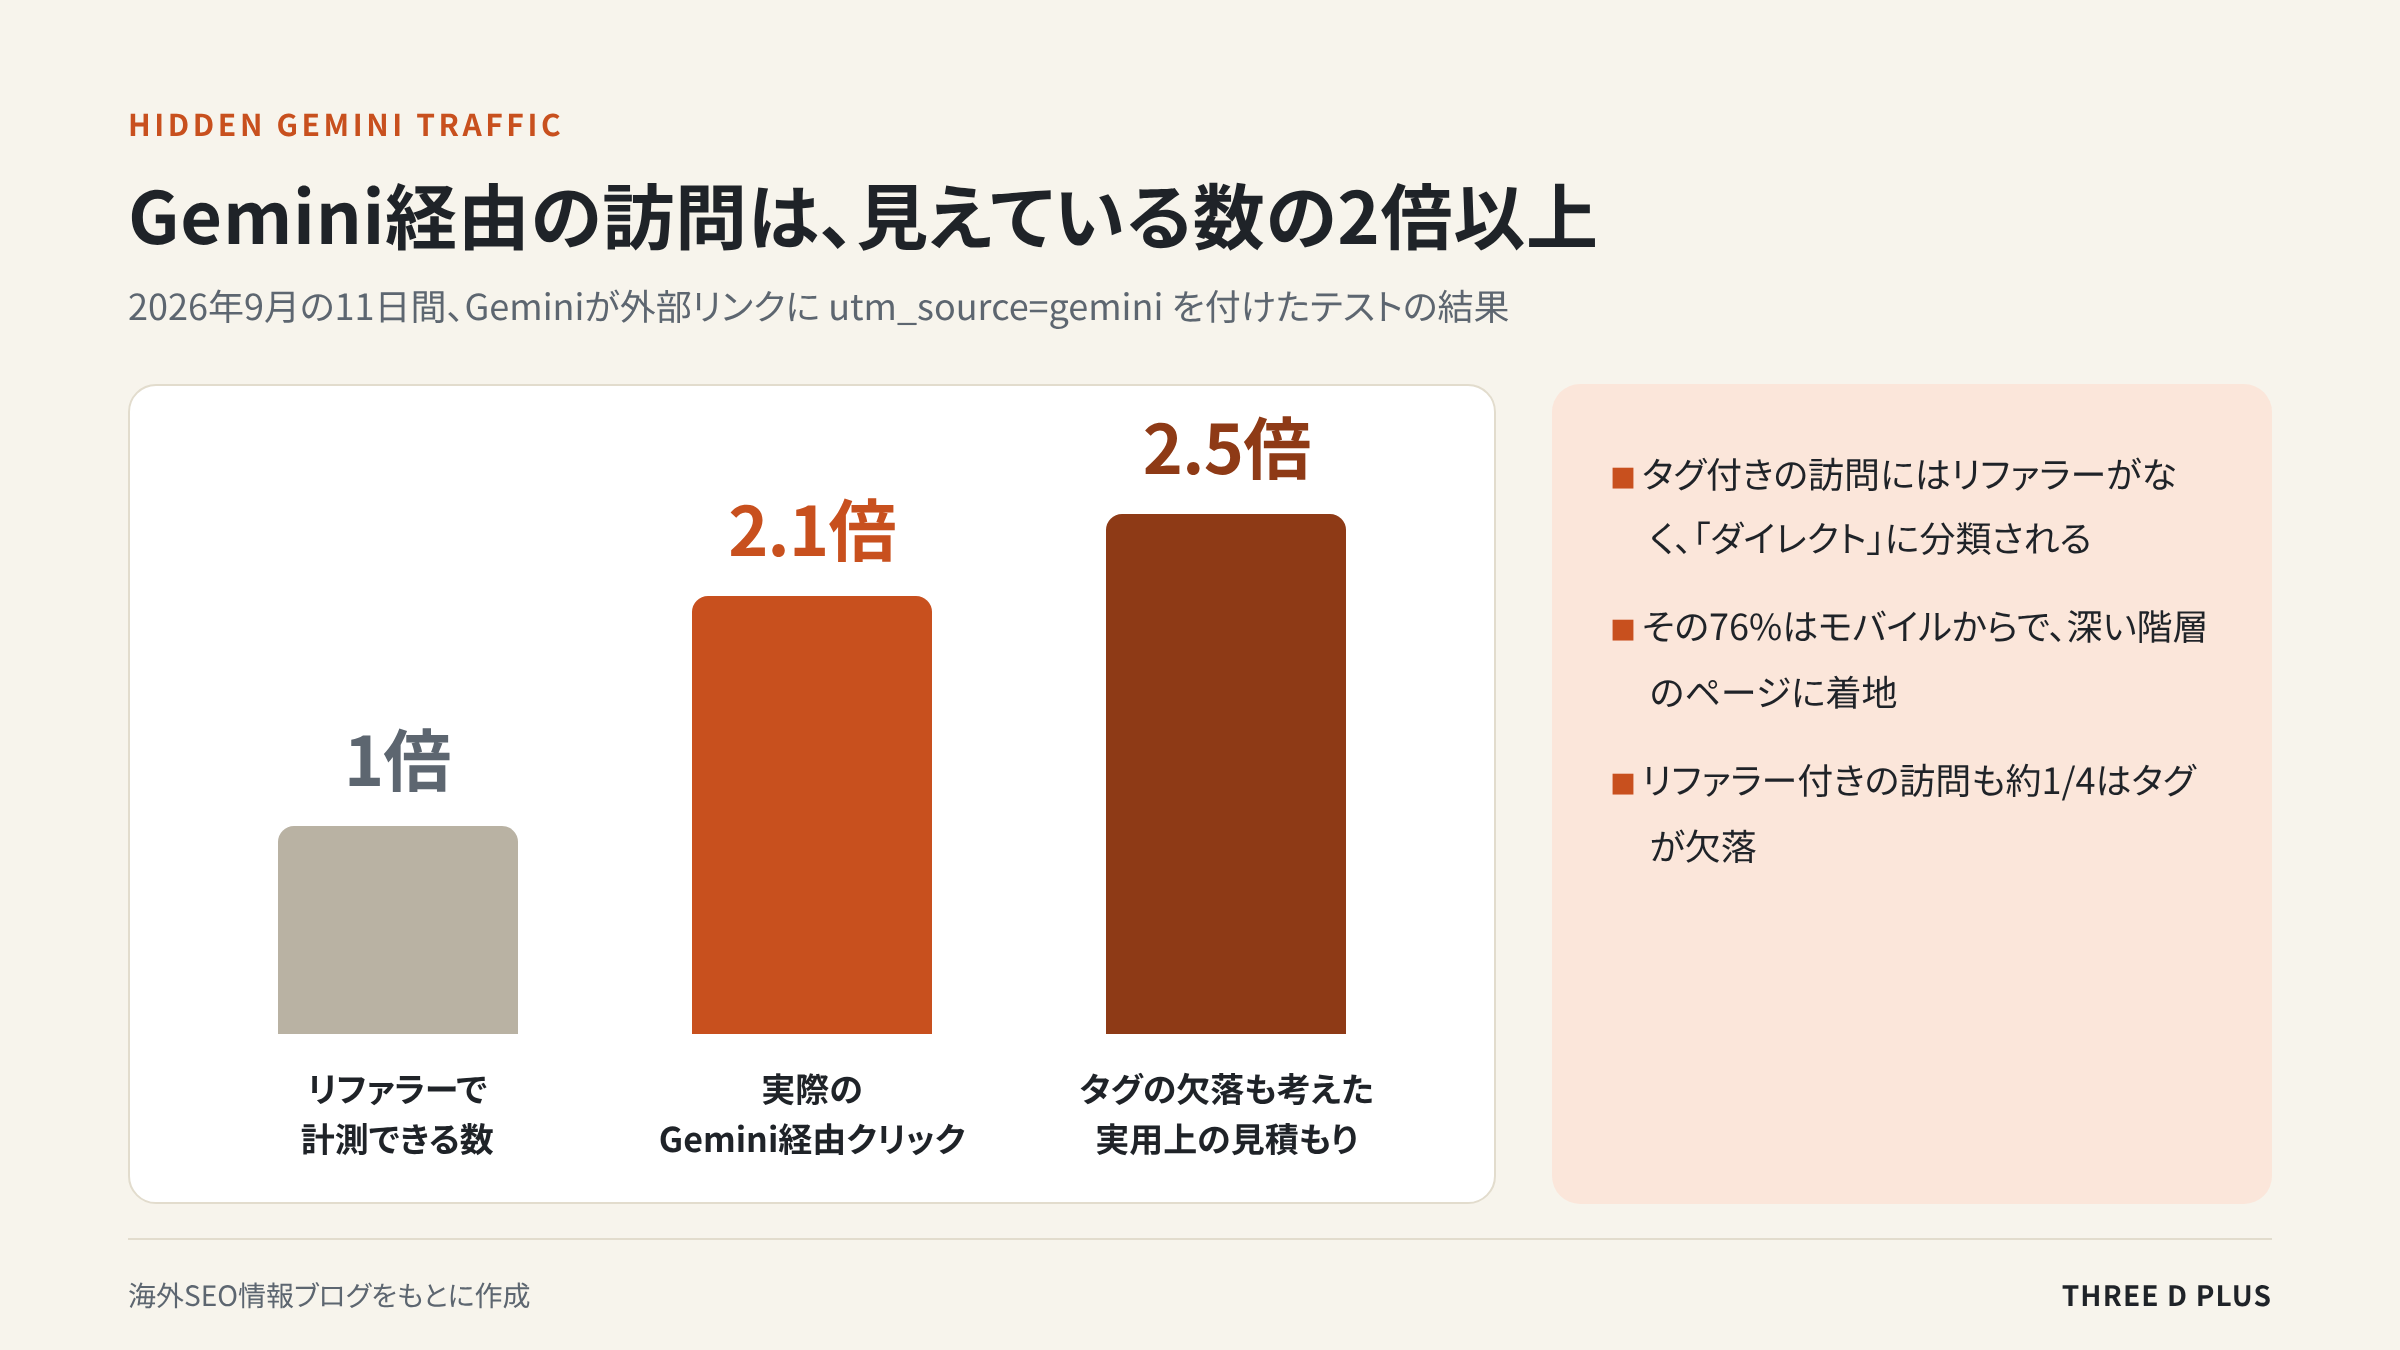
Geminiが、外部へのリンクにutm_source=geminiというタグを付けるテストを行いました。その結果、普段「ダイレクト」として計測されているアクセスの中に、Geminiからの流入が多く隠れていることが分かりました。実際のGeminiからの訪問は、リファラーで計測した数の2倍以上と推定されています。
テストで分かったこと
タグが付けられたのは、2026年9月の11日間です。Adobe AEM Operational Telemetryのデータで1,000以上のドメインを調べたところ、リファラー付きの訪問とタグ付きの訪問は同数で、タグ付きの訪問にはリファラーがありませんでした。リファラーのないタグ付きの訪問は「ダイレクト」に分類されます。その多く(76%)はモバイルからで、サイトの深い階層のページに着地していました。実際のGemini経由のクリックは、リファラーで計測した数の2.1倍です。
見落としが起きる理由と、関係者の見方
リファラー付きの訪問でも、約1/4にはタグが付いていませんでした。ネイティブアプリからのアクセスでは、HTTPリファラーが送られないことが多くあります。データを分析したCedric Huesler氏は、UTMパラメータの方がリファラーより扱いやすく、設定漏れも起きにくいという見方を示しています。GoogleのJohn Mueller氏も、どこでリファラーが失われているのか、タグとリファラーの両方が役立つのかに関心を示しました。Huesler氏は、Google検索のインデックス側でUTMパラメータを取り除くべきだとも指摘しています。
実務での対応
Geminiからのセッション数は、リファラーで見える数の最低2倍、実用上は2.5倍と見積もっておくとよいでしょう。モバイルの「ダイレクト」訪問に、AI経由の流入が混ざっていないかを確認してください。9月18〜28日のデータで、リファラーのないutm_source=geminiのセッションとgemini.google.comからのリファラルを比べると、自サイトに隠れているGemini流入の比率をつかめます。
11. Meta MuseやOpenAI DotsのようなパーソナルAIエージェントがSEOに与える意味
Meta MuseやOpenAI DotsといったパーソナルAIエージェントが登場し、ウェブの使われ方を変えつつあります(Museは米国とカナダで提供中)。エージェントはユーザーの代わりに商品を調べ、フォームに入力し、カートに入れて購入までをやり遂げます。既存のSEOやアクセス解析に大きく影響するため、サイト側にも新しい対応が求められます。
Photo by Mohamed Nohassi on Unsplash
エージェントはサイトをどう読み、どう訪れるか
Metaによると、Museはページの生のHTMLではなく、アクセシビリティツリーを読み取ります(OpenAIはDotsの読み取り方を公表していません)。そのため、見出し、リンクテキスト、altテキスト、画面に見えるテキストといったSEOの基本は引き続き重要で、ボタンやフォームなど購入を完了させる部品の作りが鍵になります。一方で、構造化データは常に読み取られるとは限りません。サイトへのアクセス方法は、コネクタ経由(API連携)とクラウドブラウザ経由の2種類です。どちらの会社もエージェントのユーザーエージェント名を公表していないため、robots.txtに書く名前がなく、訪問は顧客本人の行動として現れます。制御の手段になるのは、robots.txtではなくボット対策(ボットプロテクション)の設定です。
アクセス解析への影響
エージェントがサイトを閲覧すると、アクセス解析ではほぼ確実に顧客の訪問として数えられます。コネクタ経由の購入はサイトのアクセス解析には何も残らず、注文はプラットフォーム側の記録にしか出ません。OpenAIはDotsの利用状況を公表しておらず、エージェント経由で何件の購入が行われているかを示すデータもまだありません。
実務での対応
SEO担当とフロントエンドの担当が連携し、ボット対策(ボットプロテクション)の設定にもSEOの立場から関わってください。購入・予約・登録のページは、アクセシビリティを優先して改善しましょう。エージェントのアクセスを許可するか拒否するかの方針も、はっきり決めておく必要があります。AIに引用されることだけでなく、エージェントがサイト上で操作や購入をできる環境を整えることが、これからのビジネスに欠かせなくなります。
12. Google DiscoverのSDF鮮度アルゴリズムに関する詳細が明らかに
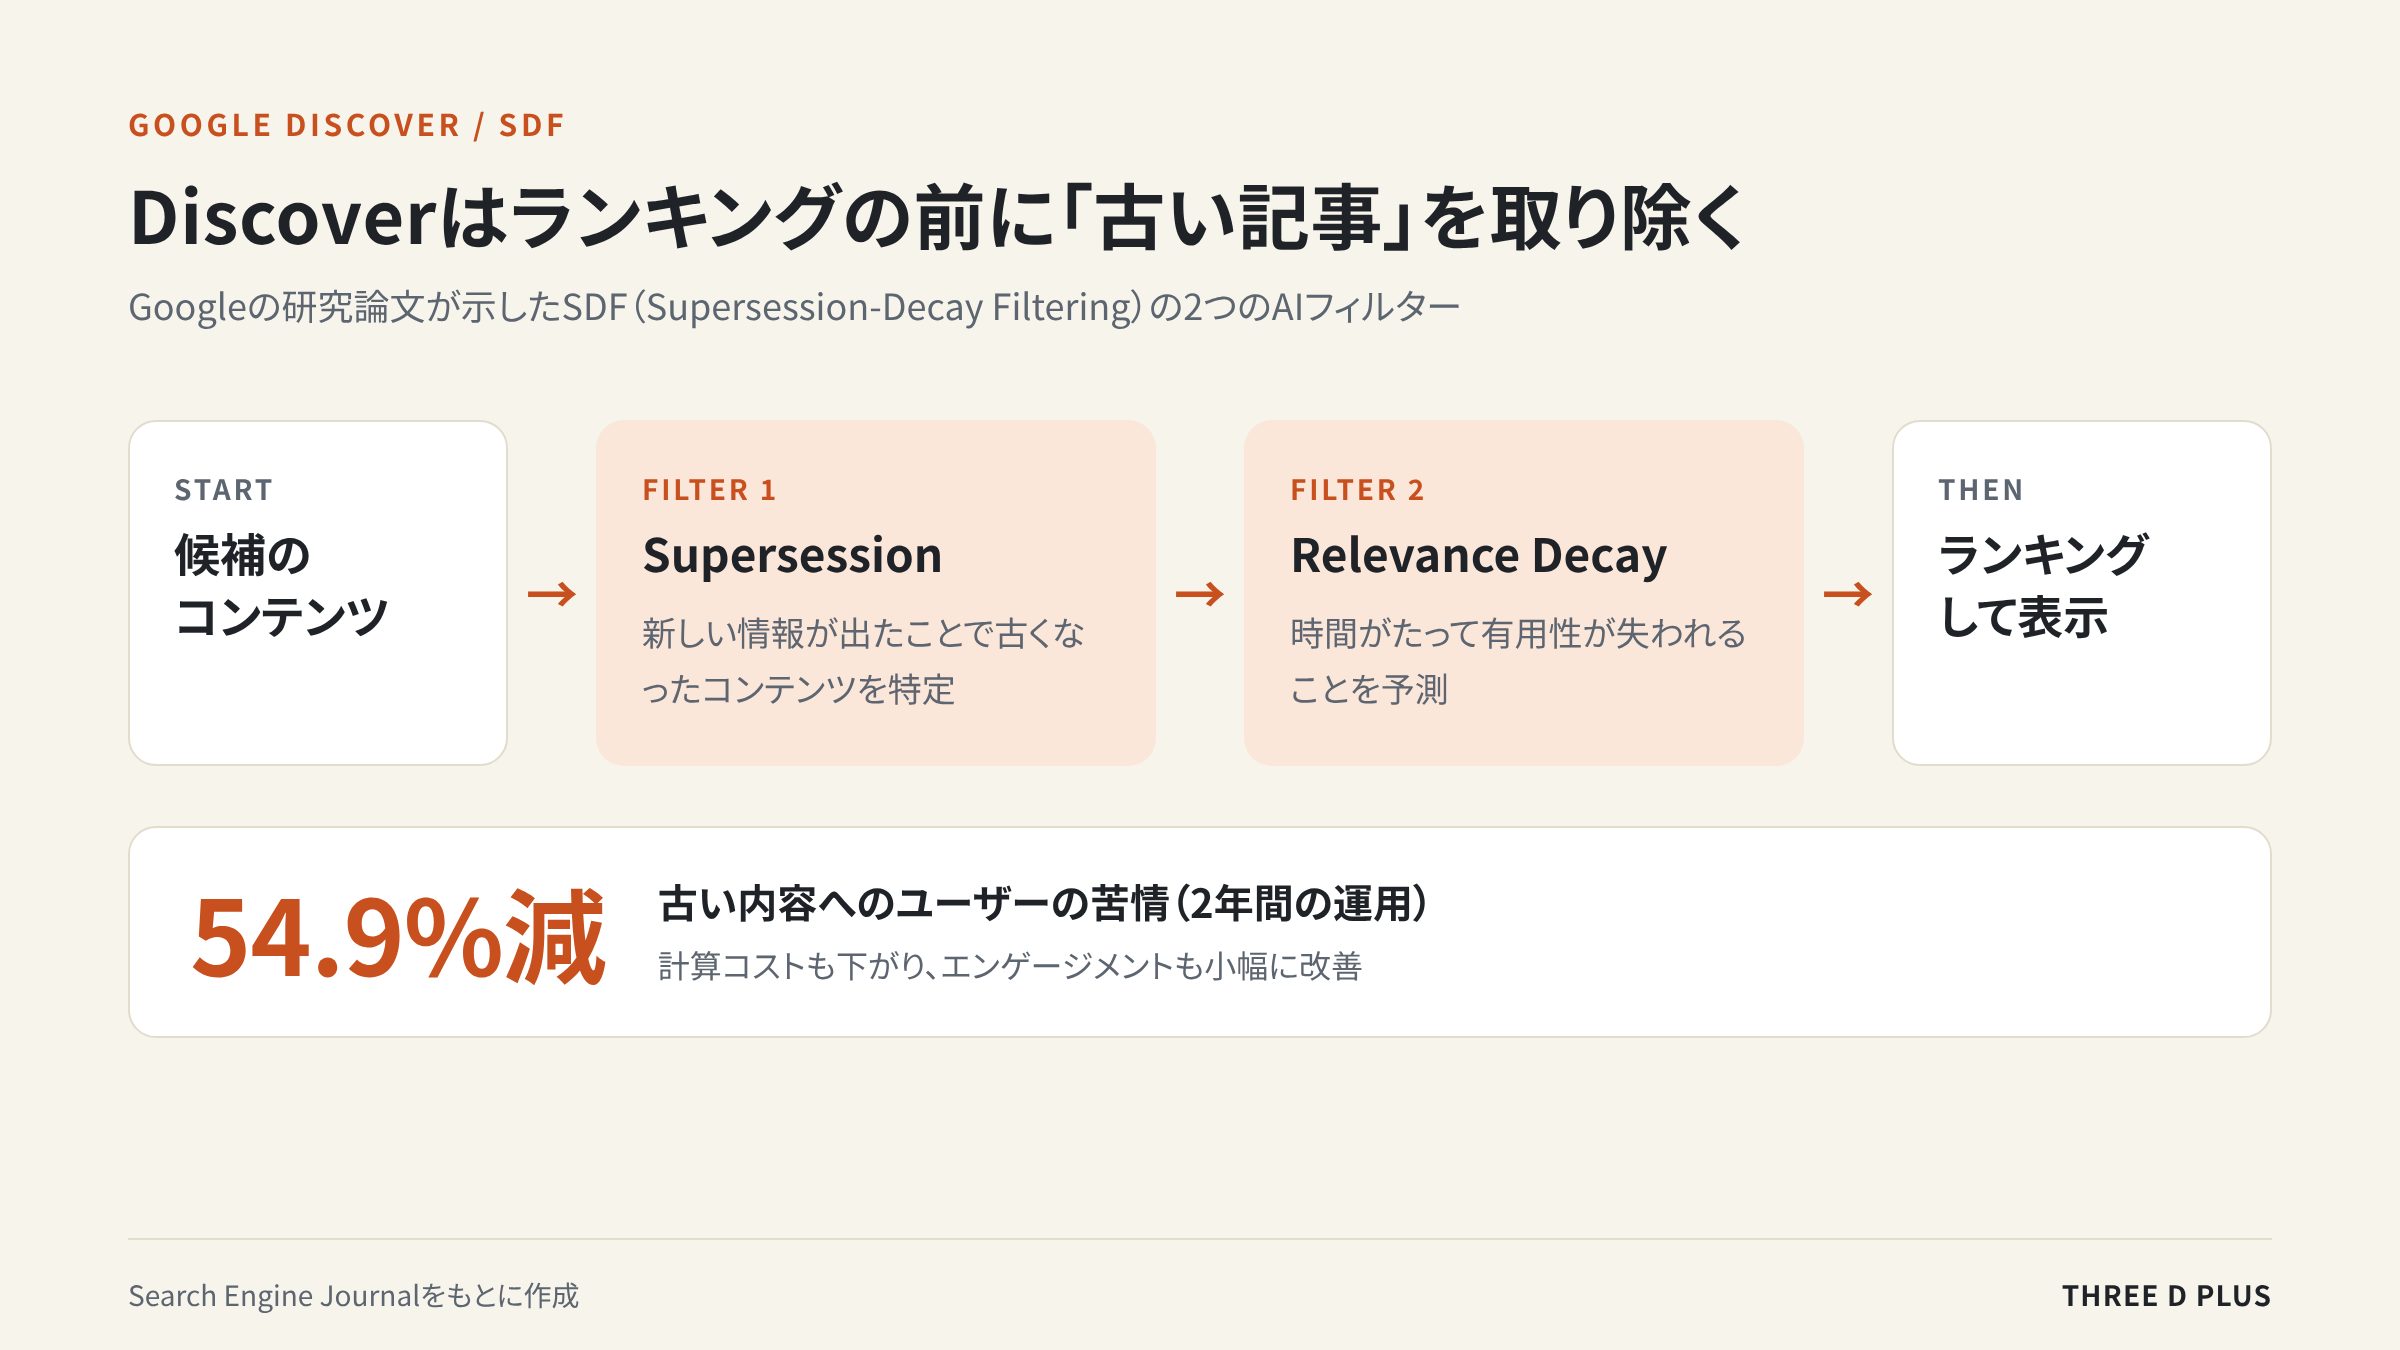
Googleが公開した研究論文で、Google Discoverで使われている「SDF(Supersession-Decay Filtering)」の詳細が明らかになりました。2つのAIフィルターで古くなったコンテンツを先に見つけて取り除き、ユーザー体験の向上とシステムの効率化を図る仕組みです。論文によると2年前から運用されており、パブリッシャーはコンテンツ戦略の見直しを求められています。
SDFの仕組み
SDFはDiscoverの鮮度を管理するシステムで、ランキングの前の段階でコンテンツをふるいにかけます。1つ目の「Supersession」は、新しい情報が出たことで古くなったコンテンツを特定します。2つ目の「Relevance Decay」は、時間がたって有用性が失われることを予測します。
なぜ導入されたか
従来の鮮度の判断には課題がありました。公開日だけでは内容が今も関連するかどうかは保証されず、いつ読んでも役立つ常時コンテンツまで外してしまうことがありました。ユーザーの反応(エンゲージメント)を見る方法は受け身で、判断が遅れます。SDFはこうした問題を解決し、古くなった推薦コンテンツを減らしました。2年間の運用で、古い内容に対するユーザーからの苦情は54.9%減りました。ランキングの前に古い記事を外すことで計算コストも下がり、エンゲージメントも小幅に改善しています。
実務での対応
常時コンテンツと期間限定のコンテンツをどのくらいの割合で持つかを考え、コンテンツの更新計画を立ててください。内部リンクの設計にも、鮮度の観点を入れることが大切です。SDFはコンテンツ戦略と内部リンク戦略の両方に新しい視点をもたらすもので、鮮度と有用性を意識したコンテンツ作りがより重要になります。
よくある質問
Q. 記事に著者プロフィールを載せれば、順位は上がりますか?
A. GoogleのSearch Liaisonは2024年1月に、著者名(バイライン)を載せても順位は上がらないと発言しています。載せる場合は、実在の人物と実際の経歴にしてください。AIで生成した顔写真や架空の経歴は「欺瞞」とされ、低品質ページのシグナルになります。
Q. AIで書いた記事を公開するときに、気をつけることは?
A. 公開前に、人の手でファクトチェックとレビューをすることが必須とされています。本文だけでなくメタデータも確認対象です。AIで大量に自動生成したテキストは「労力が低い」と評価されるため、人の作業や独自の分析を加えることが前提になります。
Q. Geminiからの流入は、アクセス解析でどう見積もればいいですか?
A. リファラーで計測できる数は実際より少なく、最低2倍、実用上は2.5倍と見積もるのが目安です。モバイルの「ダイレクト」訪問に、AI経由の流入が含まれていないかも確認してください。
Q. AIエージェントのアクセスは、robots.txtで止められますか?
A. Meta MuseやOpenAI Dotsはユーザーエージェント名を公表していないため、robots.txtに指定する名前がありません。制御できるのはボット対策の設定です。許可するか拒否するかの方針を決めたうえで、ボット対策の見直しにSEOの担当者も関わることが勧められています。
Q. Bing Webmaster ToolsのTopics Portfolioは、どこで見られますか?
A. 「AI Performance」セクションの新しいタブにあります(ベータ版)。サイトのデータが十分にない場合は表示されません。
まとめ|2026年11月のSEOで押さえること
今月の12本に共通するのは、AIに選ばれる情報の条件が「正確で、出どころがはっきりした一次情報」に寄ってきていることです。Googleは偽の作成者プロフィールや人のチェックを通さないAI記事に明確に線を引き、ChatGPTやAI Overviewsの引用元は、公式サイト、専門機関、Wikipediaのような権威性のある情報源に集まっています。一方で、Gemini経由の訪問が「ダイレクト」に紛れたり、AIエージェントの訪問が顧客として数えられたりと、AI時代のアクセスは従来の計測では見えにくくなっています。まずは、作成者情報が正確か、価格や仕様などの事実が公式サイトに正しく載っているかを確認し、あわせてアクセス解析の「ダイレクト」流入を見直すところから始めてください。
THREE D PLUS は大阪の Web 制作会社です。ホームページ制作から公開後の運用・改善までまとめてご相談いただけます。お問い合わせはこちら。